游戏逆向(一)——CC++汇编基础
从进制换算与数据宽度讲起,梳理 x86 汇编的寄存器、常用指令与函数调用约定,并结合 OllyDbg、CE 的调试实例讲解 if / switch / 循环语句的逆向识别方法。
课程进度:认识 OD 未开始
进制
主要了解进制换算的方法以及计算机常用的二进制和十六进制
二进制数据:1101
十六进制数据:E10F
十进制转其他进制(二进制为例):除以对应进制取余即可
计算机使用二进制,这里学习十六进制的原因是:
- 十六进制与二进制之间的转换相对简单
- 十六进制数表示方式紧凑
| 十六进制 | 二进制 |
|---|---|
| 1 | 0001 |
| 2 | 0010 |
| 4 | 0100 |
| 8 | 1000 |
计算机存储数据是有宽度的
计算机中存储数据的单位术语:
- 位(bit):最小单位,由0和1表示
- 字节(Byte):
- 字(WORD)
- 双字(DWORD)
计算机存在 32 位操作系统(x86)和 64 位操作系统(x64),32或64分别表示什么?
以下面的64位程序为例进行说明:

在程序中设置断点,确保程序运行至断点时临时变量 a 已经生成。
顶部菜单:调试 (Debug) → 窗口 (Windows) → 内存 (Memory) 调出内存窗口,使用取地址符查找变量 a 所在的地址,可以看到使用 16 进制表示的地址一共有 16 位,转换为二进制就是 64 位。

数据的存储模式
大端模式:指数据的低位保存在内存的高地址中,而数据的高位,保存在内存的低地址中;
小段模式(x86):是指数据的低位保存在内存的低地址中,而数据的高位,保存在内存的高地址中
举例来理解大端模式和小端模式
定义一个较大的数 0x12345678 将其赋值给某个 int 类型变量 a,由于数字较大,单个字节无法存储。我们来观察其对应的数据存储模式

可以看到两个十六进制为一组,正好为 8 位一个字节,78 为数据低位因此保存在地址中的较低的位置。12 为数据的高位因此保存在地址中的较高的位置。
将数据值改为 2,结果如下,只有地址中的低位被占据,而高位留空:

寄存器
寄存器在 CPU 内。
计算机存储数据的位置有(读取速度排列)
CPU > 内存 > 硬盘
32 位通用寄存器的指定名称以及用途
1 ,eax 累加器操作数以及结果数据的累加器,也经常用作一个 call 的返回值
2 ,ecx 计数器 字符串和循环操作的计数器
3 ,edx 用于保存乘法形成的的部分结果或者除法之前部分被除数
4 ,ebx 基地址, DS 段的数据指针,在内存寻址时存放基地址
5 ,esp 堆栈指针,经常被称为栈顶指针
6 .ebp 栈底指针
7 ,esi 字符串操作的源指针
8 ,edi 字符串操作的目标指针
上述寄存器都是通用的,只是通常执行对应功能。
x86 架构下上述寄存器都是 4 个字节宽度。
通用寄存器的逻辑结构
| 16-31 | 0-15 | 15-0 | 8-15 | 0-7 |
|---|---|---|---|---|
| ea | x | ax | ah | al |
| ec | x | cx | ch | cl |
| ed | x | dx | dh | dl |
| eb | x | bx | bh | bl |
| es | p | sp | ||
| eb | p | bp | ||
| es | i | si | ||
| ed | i | di |
尝试利用寄存器存储数据:
在 C++ 中嵌入汇编代码使用关键字
__asm
2
3
4
5
6
7
8
{
__asm
{
mov eax, 1
}
return 0;
}上述代码中
mov相当于 C++ 中的赋值语句。为该语句下断点进行调试(注意将调试器改为 x64Debug 模式):顶部菜单:调试 (Debug) → 窗口 (Windows) → 寄存器 (Register) 调出寄存器窗口

可以看到累加器的值为
CCCCCCCC即空值,执行赋值操作(逐过程),可以发现累加器的数值发生变化,即数值写入成功
执行以下代码,可以发现只对 0-15 的数据进行了更改
2
mov ax, 0xBBB
认识 OD
OD(OllyDbg):32 位程序调试工具(将二进制程序转为汇编语言)
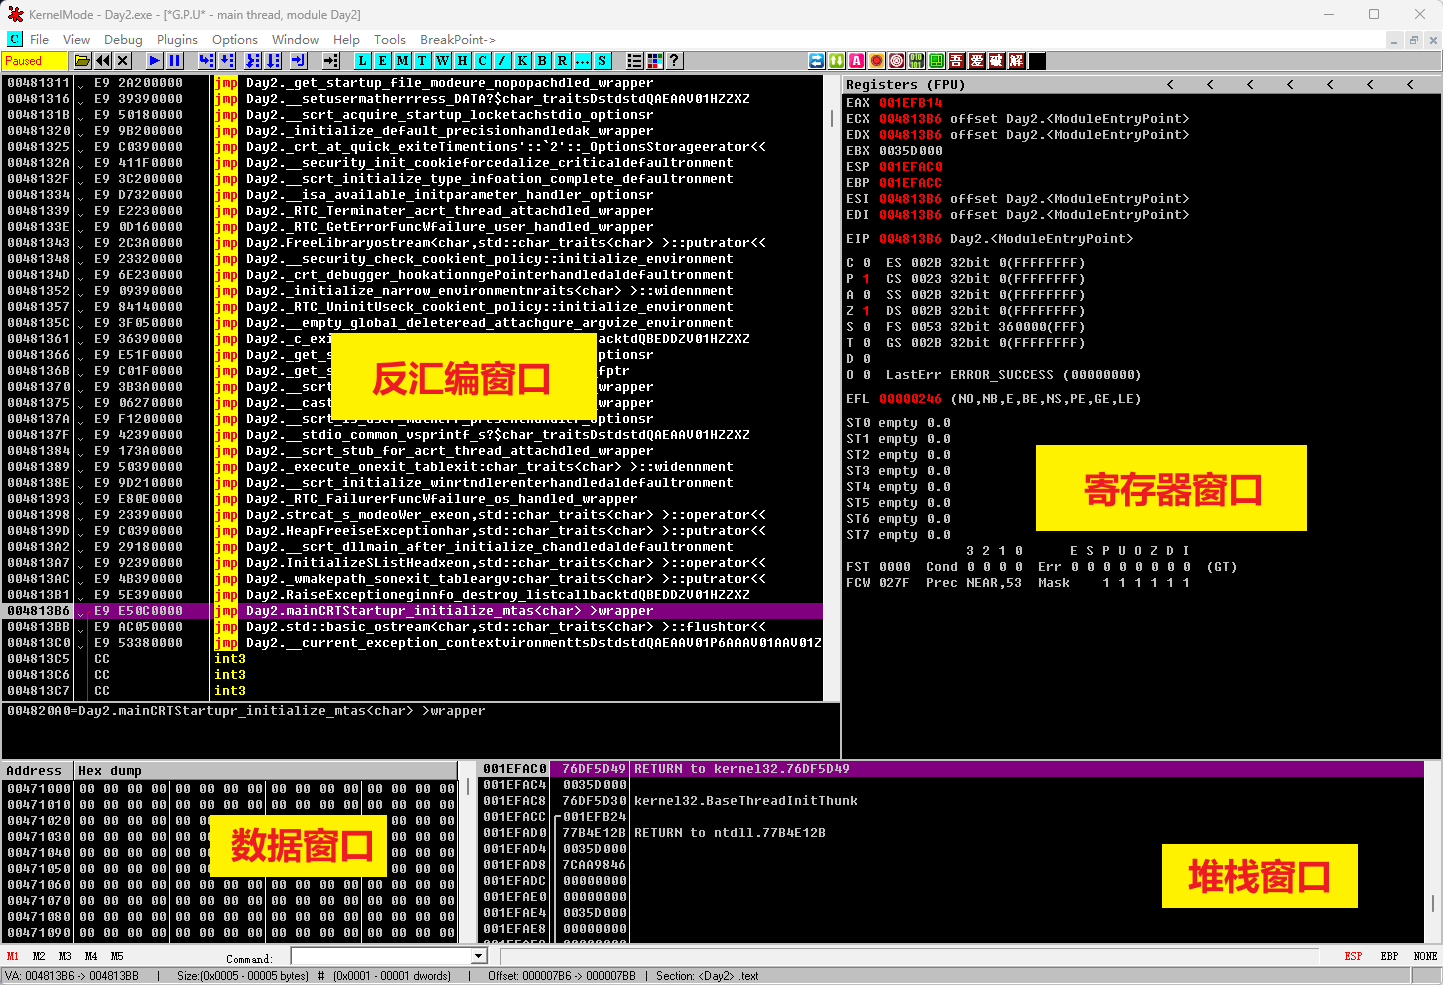
寄存器窗口只在程序运行至断点时才会有值(因为寄存器一直在输入输出数据)
反汇编窗口:主要查看代码,将二进制硬编码数据转化为汇编语言
数据窗口:主要查看数据,比如人物的血量数据为 100,那么在数据窗口就会出现 100 的十六进制编码数据
基本操作
开始调试:打开文件或将程序拖动至调试窗口内
剥离:右键→StrongOD→Detach
我们以之前课程所编译的 x86 程序为例

无论是汇编窗口、数据窗口,本质都是对于内存地址进行不同类型的解析。
跳转:Ctrl + G 输入地址即可进行跳转


调试快捷键F7:单步步入(进入到函数内部)F8:单步步过(直接将函数执行完)Ctrl + F9:执行到返回(从函数中出来)
设置断点(int3断点 软件断点 cc断点):F2 (变红)
CPU 指令集
参考文档
汉化版:Intel IA-32 指令集 By:网事如风(主要)
文档界面:

OllyDBG 编码
(1)打开汇编窗口:

(2)编写一段汇编指令:
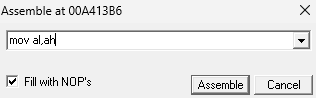
表示将寄存器 ah 段的数据赋值到 al 段
查看硬编码为 8AC4 ,即表示
| 操作码 | 指令 | 说明 |
|---|---|---|
| 8A /r | MOV r8,r/m8 | 将 r/m8 移到 r8 |
将寄存器的数据赋值给寄存器
(3)单步运行:
EAX 寄存器原数据为 006FFE5C
运行后数据为 006FFEFE
证明赋值操作执行成功
mov 指令
下面继续编写另一条指令:
语法上通过,硬编码为
883D
操作码 指令 说明 88 /r MOV r/m8,r8 将 r8 移到 r/m8 将寄存器数据写入某个地址
在执行过程中会出现错误,涉及计算机中地址分配的内容:
地址段 功能 0x00000000 64kb 空指针赋值分区 0x00010000 未映射区 (用户区 2G) 代码段 初始化数据区 堆 --- 栈 命令行参数和环境变量 0xfffeffff 64kb 禁入分区 0x7fffffff (内核区 2G) 0xffffffff 上面的代码使用了用户区外的地址,因此会导致程序直接崩溃
(1)编写一段代码将立即数 7 写入到寄存器 bh 中
立即数:常量
(2)将 7 赋值到某段内存地址中(在编写的过程中 ptr 和 ds 都可省略)
2
mov dword [003CFCC8],7由于立即数和内存地址都无法确定宽度,就需要提前声明数据大小
76325D49->00000007
lea 指令
| 操作码 | 指令 | 说明 |
|---|---|---|
| 8D /r | LEA r16,m | 将 m 的有效地址存储到寄存器 r16 |
| 8D /r | LEA r32,m | 将 m 的有效地址存储到寄存器 r32 |
观察以下两行代码:
1 | lea eax,dword ptr ds:[0x3CFCC8] |
运行结果
1 | 0x003CFCC8:00000007 |
不难发现,lea 直接将地址写入了寄存器,而 mov 是取地址内的值再将其赋值给寄存器
在 C++ 中进一步说明:
编写一条赋值语句,查看反汇编代码:

使用的是 mov 指令:

关闭显示符号名后汇编代码为:
- 其中
ebp-8为局部变量,可以将其理解为某个地址继续编写另一条取地址语句:
2
int* b = &a;反汇编代码为:
2
3
007344B2 lea eax,[ebp-8]
007344B5 mov dword ptr [ebp-14h],eax其中第二段代码就是执行的取地址运算
add sub inc dec
add:加法指令(需要保证位数相等)
1 | add al, 7 |
sub:减法指令(类似)
inc:自增1
1 | inc eax |
dec:自减1
标志寄存器(EFL)
共有四个字节,按位进行查看,每一位都代表一个标志

| 标志位(外语缩写) | 标志位名称及外语全称 | =1 | =0 |
| CF | 进位标志/Carry Flag | CY/Carry/进位 | NC/No Carry/无进位 |
| PF | 奇偶标志/Parity Flag | PE/Parity Even/偶 | PO/Parity Odd/奇 |
| AF | 辅助进位标志/Auxiliary Carry Flag | AC/Auxiliary Carry/进位 | NA/No Auxiliary Carry/无进位 |
| ZF | 零标志/Zero Flag | ZR/Zero/等于零 | NZ/Not Zero/不等于零 |
| SF | 符号标志/Sign Flag | NG/Negative/负 | PL/Positive/非负 |
| TF | 跟踪标志/Trace Flag | ||
| IF | 中断标志/Interrupt Flag | EI/Enable Interrupt/允许 | DI/Disable Interrupt/禁止 |
| IF | 中断标志/Interrupt Flag | EI/Enable Interrupt/允许 | DI/Disable Interrupt/禁止 |
| DF | 方向标志/Direction Flag | DN/Down/减少 | UP/增加 |
| OF | 溢出标志/Overflow Flat | OV/Overflow/溢出 | NV/Not Overflow/未溢出 |
学习标志寄存器的意义:判断跳转与否
1、JE, JZ结果为零则跳转(相等时跳转) ZF=1
2、JNE, JNZ结果不为零则跳转(不相等时跳转) ZF=0
3、JS结果为负则跳转 SF=1
4、JNS结果为非负则跳转 SF=0
5、JP, JPE结果中1的个数为偶数则跳转 PF=1
6、JNP, JPO结果中1的个数为偶数则跳转 PF=0
7、JO结果溢出了则跳转 OF=1
8、JNO结果没有溢出则跳转 OF=0
9、JB, JNAE小于则跳转 (无符号数) CF=1
10、JNB, JAE大于等于则跳转 (无符号数) CF=0
11、JBE, JNA小于等于则跳转 (无符号数) CF=1 or ZF=1
12、JNBE, JA大于则跳转(无符号数) CF=0 and ZF=0
13、JL, JNGE小于则跳转 (有符号数) SF≠ OF
14、JNL, JGE大于等于则跳转 (有符号数) SF=OF
15、JLE, JNG小于等于则跳转 (有符号数) ZF=1 or SF≠ OF
16、JNLE, JG大于则跳转(有符号数) ZF=0 and SF=OF
位运算
and:按位与(&&)
or:按位或
not:按位取反
上面的概念在 C++ 中都讲解过,注意只能对二进制进行操作即可
cmp test
cmp:执行了一次减法操作但只影响标志位,但是不改变寄存器内的值,经常与条件跳转共同使用
逐步运行以下代码,观察寄存器 eax 值的变化和标志寄存器的数值变化情况:


执行 add 指令,寄存器数据发生变化
零标志判定为否,因此有
1的个数为偶数,因此有 
执行 cmp 指令,寄存器数据不发生改变,但是标志寄存器中数据发生变化。
零标志判定为否,因此有
1的个数为奇数,因此有 JZ结果为零时跳转(cmp 的两数相等,即相减为零,
时发生跳转),所以该步执行完毕后应该不跳转继续顺序执行下一步 
验证了上述的分析正确。
对比 cmp 和 sub 的关系,test 和 add 的关系也类似
push pushad pop popad
push:将字或双字压入堆栈(寄存器,内存地址,立即数等)
ESP 通用寄存器内存放的数据为栈点地址
EBP 栈底地址寄存器

pop:将栈顶的值弹出堆栈(弹出至寄存器/内存地址)

pushad:将通用寄存器中的内容一次性压入堆栈
| 操作码 | 指令 | 说明 |
|---|---|---|
| 60 | PUSHA | 压入 AX、CX、DX、BX、原始 SP、BP、SI 及 DI |
| 60 | PUSHAD | 压入 EAX、ECX、EDX、EBX、原始 ESP、EBP、ESI 及 EDI |
popad:同理
jmp call ret eip
EIP:保存即将要执行的代码段地址的寄存器
1 | jmp short 地址 |
- short:代表跳转的位置距离当前代码较近(128 字节内)
call:与 jmp 类似也是跳转到对应代码段,但是 call 在跳转到函数实现的位置时会将 call 代码下一个代码段的地址 push 到堆栈中,方便函数执行完毕后返回原位置继续执行。
ret:相当于
1 | pop EIP |
演示堆栈:
C++ 代码如下:
2
3
4
5
6
7
8
9
10
11
{
return a + b;
}
int main()
{
int res = add(1, 2);
return 0;
}汇编代码:
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
003717D0 push ebp // EBP:栈底,把外层栈底 PUSH 保存到堆栈里
003717D1 mov ebp,esp // 将当前的栈顶作为新的栈底
003717D3 sub esp,0C0h // 开辟新的堆栈空间用来存储 add 函数中的数据
003717D9 push ebx
003717DA push esi
003717DB push edi // 保存 main 函数寄存器的当前状态
003717DC mov eax,dword ptr [ebp+8] // ebp + 8 即为第一个参数 2
003717DF add eax,dword ptr [ebp+0Ch] // ebp + 0Ch(12) 即为第二个参数
003717E2 pop edi
003717E3 pop esi
003717E4 pop ebx // 还原 main 函数中寄存器状态
003717E5 mov esp,ebp // 还原开辟的堆栈空间,此时栈顶指向存储 main 函数栈底的位置
003717E7 pop ebp // 将 main 函数栈底还原
003717E8 ret // 弹出 返回地址
->
003726CB push 2 // 先 push 后面的参数,ESP 寄存器提升 4 个字节
003726CD push 1
003726CF call 003713ED // jmp 到指定位置,并 push 003726D4 到堆栈
003726D4 add esp,8 // 将堆栈中的保存的参数弹出
003726D7 mov dword ptr [ebp-8],eax
- 每个函数都有自己的栈底,当前在哪个函数内部,ebp寄存器所存储的栈底即为哪个函数的

数据类型的边界和溢出
char
char:一个字节,8位,共256个数据,数据取值范围
至于为什么采用这种取值类型,后续在 int 类型中会进行说明
int
int:四个字节,32位,4,294,967,296个数据,我们知道 int 是整型数据,既可以是正整数也可以是负整数,为了保证规范性,char 也采用了类似的数据值计算方法,这就解释了为什么 char 类型也会取到负值。
0000 0000 0000 0000 0000 0000 0000 0011=3
0111 1111 1111 1111 1111 1111 1111 1111=2,147,483,647
1000 0000 0000 0000 0000 0000 0000 0000=-2,147,483,648
1111 1111 1111 1111 1111 1111 1111 1111=-1
此处涉及了补码这一操作,比如我们希望获得 -3 的 32 位二进制编码:
- 先取反:1111 1111 1111 1111 1111 1111 1111 1100
- 再加1:1111 1111 1111 1111 1111 1111 1111 1101=-3
补码的核心优势:减法可以变为加法
数组指针与多维数组内存
数组本身为指针类型。多维数组同样是按顺序存储在内存中的。
字符串指针与编码
字符串指针
单个 char 在内存地址中占一个字节 8 位,编写一段 C++ 代码观察字符串在内存中的存储方式
1 | char* b = (char*)"12345fedba"; |


字符串在内存中是直接按顺序进行存储的
字符串编码
ascii:中文占两个字节(代码页)
unicode:所有字符都占两个字节
utf- 8:中文占三个字节,ascii 码只占单个字节
big5
浮点在内存中如何存放
浮点数在内存中的存储方式遵循 IEEE 754 标准,存储格式为
其中 s 是符号位, M 表示有效数字, E 表示指数 [2]。 对于 32 位浮点数,其存储结构为:
高位为符号位 接着 8 位为指数位,剩余的 23 位为有效数字。实际可保存的有数字位为 24 位

5.125:
5:0101
0.125:0.125 * 2 = 0.250 无进位 0101.0
0.250:0.250 * 2 = 0.500 无进位 0101.00
0.500:0.500 * 2 = 1.000 有进位 0101.001
1.000:1.000 - 1 = 0 无余数 算法结束
0.1:
0.1:0.1 * 2 = 0.2 无进位 0.0
0.2:0.2 * 2 = 0.4 无进位 0.00
0.4:0.4 * 2 = 0.8 无进位 0.000
0.8:0.8 * 2 = 1.6 有进位 0.0001
1.6:1.6 - 1 = 0.6 有余数 算法继续
0.6:0.6 * 2 = 1.2 有进位 0.00011
1.2:1.2 - 1 = 0.2 有余数 算法继续
0.2 之前已经出现因此算法出现循环,会一直计算直至溢出精度,因此浮点数会丢失精度
float 究竟有多大又究竟有多小
遑论 double 双精度浮点数
逆向 if 语句
C++ 代码:
1 | int a = 1; |
反汇编代码:
1 | 000B44AB mov dword ptr [ebp-8],1 |
- 这里用到了之前的 mov,cmp和跳转指令
- jle:小于等于则跳转,le 是 less equal 的缩写
逆向 switch 语句
C++ 代码
1 | int a = 1; |
反汇编代码:
1 | 008D44AB mov dword ptr [ebp-8],1 |
- 在判断前进行了多次的赋值操作,这是编译器构建的规则,我们只需要能看懂代码即可
- 本质多次执行 if 语句
C++ 代码:
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
switch (a)
{
case 1:
{
printf("1");
break;
}
case 2:
{
printf("2");
break;
}
case 3:
{
printf("3");
break;
}
case 4:
{
printf("4");
break;
}
}
return 0;反汇编代码:
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
00FD44B2 mov eax,dword ptr [ebp-8]
00FD44B5 mov dword ptr [ebp+FFFFFF30h],eax
00FD44BB mov ecx,dword ptr [ebp+FFFFFF30h]
00FD44C1 sub ecx,1 // 数组从零开始计数
00FD44C4 mov dword ptr [ebp+FFFFFF30h],ecx
00FD44CA cmp dword ptr [ebp+FFFFFF30h],3 // 大于 4 直接跳出
00FD44D1 ja 00FD451A
00FD44D3 mov edx,dword ptr [ebp+FFFFFF30h]
00FD44D9 jmp dword ptr [edx*4+00FD4530h] // 采用初始地址 + 偏移量,1,2,3,4 四个跳转点地址均存放在这一段连续的内存中
00FD44E0 push 0FD7BCCh // 1
00FD44E5 call 00FD13CF
00FD44EA add esp,4
00FD44ED jmp 00FD451A
00FD44EF push 0FD7BD4h // 2
00FD44F4 call 00FD13CF
00FD44F9 add esp,4
00FD44FC jmp 00FD451A
00FD44FE push 0FD7BD0h // 3
00FD4503 call 00FD13CF
00FD4508 add esp,4
00FD450B jmp 00FD451A
00FD450D push 0FD7BD8h // 4
00FD4512 call 00FD13CF
00FD4517 add esp,4
00FD451A xor eax,eax
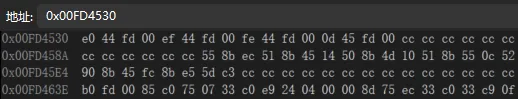
在判断数大于 3 后,汇编程序会自动采用空间换时间的方法来编译,加快程序执行的效率
逆向循环语句
while
C++ 代码:
1 | int a = 2; |
反汇编代码:
1 | 00AB17EB mov dword ptr [ebp-8],2 |
向上跳转是循环的一个特征
for
C ++ 代码:
1 | int a = 0; |
反汇编代码:
1 | 009318AC mov dword ptr [ebp-8],0 |
OD 堆栈演示
程序准备
OD 堆栈演示(这将是我们第一次尝试逆向一个完整的程序)
编写一个带有提示窗口的 C++ 程序:
1 |
|
其中 MessageBoxW 会弹出一个错误提示窗口(Warning),可以让程序执行卡在某个位置,方便断点调试
编译并尝试运行,除了黑色控制台窗口外,程序也弹出了错误警告窗口,关闭警告窗口后程序正常退出

代码定位
打开 OD,添加编译好的程序并运行

搜索 MessageBoxW 函数所在位置,Ctrl + G 进行跟随,F2 在函数出口处下断点

关闭警告窗口,程序继续执行时就会卡在刚才设置的断点处

取消断点,F7 跳出函数后就来到了 main 函数的代码段

函数特征
头部:
2
3
4
5
6
00C81811 mov ebp,esp // 当前栈顶作为内部函数栈底
00C81813 sub esp,0D8h // 开辟临时变量存储空间
00C81819 push ebx
00C8181A push esi
00C8181B push edi // 保存当前寄存器状态尾部:
2
3
4
5
6
00C81831 pop esi
00C81832 pop ebx
00C81833 mov esp,ebp
00C81835 pop ebp
00C81836 ret // 返回
代码调试
主函数调用阶段
最好先下断点,后续再次重启程序时能够迅速定位到相应位置
逐段执行代码,观察堆栈区和寄存器中数据变化
1 | 00C81963 6A 02 push 0x2 |


1 | 00C81967 E8 25F7FFFF call Day2.00C81091 |


1 | 00C81091 /E9 7A070000 jmp Day2.add // 无条件跳转至函数所在位置 |
函数体
1 | 00C81810 > 55 push ebp |


此处不难发现一个特点:
当前所在函数的栈底地址内存储的数据为外部函数的栈底地址
1 | 00C8181C C745 F8 0100000>mov dword ptr ss:[ebp-0x8],0x1 |

1 | 00C8182A 8B45 08 mov eax,dword ptr ss:[ebp+0x8] |
函数局部变量特征:
函数传入参数特征
1 | 00C81830 5F pop edi ; 00B3F7B0 |
还原寄存器状态
1 | 00C81833 8BE5 mov esp,ebp |

1 | 00C81835 5D pop ebp ; 00B3F7B0 |
还原栈底地址
1 | 00C81836 C3 retn |
相当于执行:
1
2pop eip
jmp eip
主函数还原堆栈
1 | 00C8196C 83C4 08 add esp,0x8 |

堆栈区栈顶之前与未执行函数之前的状态应该保持一致,只不过编写文档的过程中执行了两次,因此堆栈内的数据地址发生了一些变化
函数的调用约定
函数约定就是告诉编译器怎么传递参数,怎么传递返回值,怎么平衡堆栈
__cdecl :
C/C+ + 默认方式,参数从右向左入栈,主调函数负责栈平衡。外平栈
外平栈,在 call 返回后释放堆栈中的参数
1
200C81836 C3 retn
00C8196C 83C4 08 add esp,0x8
__stdcall.
windows API 默认方式,参数从右向左入栈,被调函数负责栈平衡。内平栈
内平栈,在执行 ret 时一并释放堆栈
1
ret 8 // 栈顶地址 +8,相当于移动 64 位,即两个 int 数据的大小
__fastcall :
快速调用方式。所渭快速,这种方式选择将参数优先从寄存器传入 ( ECX 和 EDX) ,剩下的参数再从右向左从栈传入。因为栈是位于内存的区域,而寄存器位于 CPU 内,故存取方式快于内存,故其名曰 "__fastcall" 内平栈
CE 内存扫描
字符串扫描
尝试使用 CE 搜索某个程序中的字符串在内存中的位置,这里以自己编写的一个游戏数据管理软件为例

首先在 CE 中附加对应程序的进程,设置搜索类型,输入想要搜索的文本
